

Un server continua a funzionare dopo il guasto di un hard disk. I file rimangono accessibili, le macchine virtuali non si fermano e il NAS segnala semplicemente che un’unità di memorizzazione deve essere sostituita. È esattamente ciò che ci si aspetta da un sistema RAID: tollerare certi tipi di guasti hardware senza interrompere l’accesso ai dati.
Il fatto è che il momento più pericoloso può manifestarsi a guasto avvenuto, durante il tentativo di ripristinare la ridondanza ovvero ricostruire sul nuovo disco i dati mancanti, riportando il RAID alla capacità originale di tolleraranza ai guasti.
Un secondo disco potrebbe contenere settori illeggibili, ossia porzioni della superficie magnetica dalle quali non è più possibile recuperare i dati, impedendo così di ricostruire alcune informazioni mancanti. Il controller RAID potrebbe inoltre avere escluso un’unità ancora funzionante a causa di un errore temporaneo di comunicazione, di un cavo difettoso o di un tempo di risposta eccessivo. Infine, alcune informazioni di parità, utilizzate per ricostruire i dati in caso di guasto, potrebbero non corrispondere più ai blocchi effettivamente memorizzati, per esempio a causa di una scrittura interrotta improvvisamente. In queste condizioni, un’operazione apparentemente ordinaria come la ricostruzione dell’array può trasformarsi in una perdita di dati.
Il rischio maggiore: un errore di lettura mentre il RAID ricostruisce i dati
Immaginiamo una configurazione RAID 5 (distribuisce dati e informazioni di parità su almeno tre dischi, permettendo di continuare a utilizzare il sistema anche se una delle unità si guasta) composta da quattro hard disk da 12 TB. Quando un disco si guasta, il sistema può ricostruire i blocchi mancanti utilizzando dati e parità conservati sulle altre tre unità. Per ripristinare un disco sostituito, una ricostruzione tradizionale potrebbe richiedere la lettura di circa 36 TB complessivi dalle unità superstiti.
Il problema è che un disco apparentemente sano può contenere settori che non riesce più a leggere: i produttori definiscono nelle specifiche un tasso di errori non recuperabili, spesso indicato come URE (Unrecoverable Read Error).
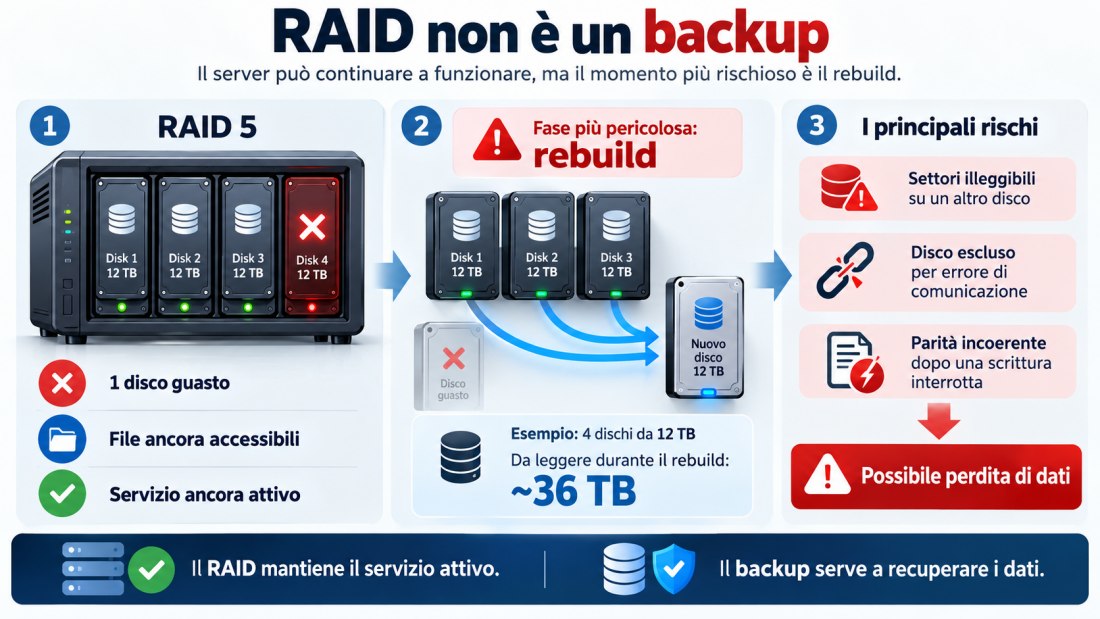
Supponendo che la probabilità di errore sia indipendente per ogni bit e pari a 1 su 10¹⁵, la lettura di 36 TB comporterebbe una probabilità teorica di incontrare almeno un errore vicina al 25%. Questo non significa che la fase di rebuild dell’array abbia il 25% di probabilità di fallire: i valori dichiarati dai produttori non descrivono una probabilità uniforme per ogni bit e le implementazioni RAID possono reagire diversamente agli errori.
Il dato serve però a evidenziare un problema: durante la ricostruzione RAID, il sistema deve accedere anche a informazioni che potrebbero non essere state lette da molto tempo.
In un RAID 5 degradato, un settore illeggibile su un disco superstite può impedire di ricostruire uno o più blocchi. Il risultato può variare dalla perdita di alcuni dati all’interruzione dell’intera procedura.
Un disco espulso dal RAID può non essere davvero guasto
Non tutte le unità contrassegnate come guaste presentano un difetto fisico.
Un timeout SATA, ossia il mancato completamento di una richiesta di lettura o scrittura entro il tempo previsto, può indurre il controller a considerare il disco non più affidabile. Lo stesso può accadere per un cavo difettoso o mal collegato, oppure per un problema del backplane, la scheda elettronica che collega i dischi al controller e all’alimentazione, tipica di NAS e server. Anche un’interruzione o un’instabilità dell’alimentazione può provocare una disconnessione temporanea.
In tutti questi casi, il RAID potrebbe escludere un’unità che, dal punto di vista meccanico ed elettronico, è ancora perfettamente funzionante.
Il problema più delicato riguarda l’eventuale reinserimento dell’unità bollata come problematica. Se dopo l’espulsione il RAID ha continuato a ricevere nuove scritture, il disco escluso contiene una versione precedente di alcuni blocchi. Così, reinserirlo forzatamente nell’array senza verificare lo stato dei metadati può introdurre informazioni obsolete nella configurazione.
Come usare il comando mdadm su Linux
Linux MD RAID (Multiple Devices RAID) è il sistema RAID software integrato nel kernel Linux, che permette di combinare più dischi in un unico volume con ridondanza, senza utilizzare un controller RAID hardware dedicato. Si configura e gestisce principalmente tramite l’utilità mdadm che, con la sintassi, seguente permette di esaminare i metadati di un membro:
sudo mdadm --examine /dev/sdX
È utile osservare l’identificativo dell’array, il ruolo dell’unità e il contatore Events, che aiuta a identificare differenze nella storia degli aggiornamenti. Il comando deve riferirsi al dispositivo o alla partizione che contiene effettivamente i metadati RAID.
Un contatore inferiore rispetto agli altri membri è un segnale da approfondire, non un’autorizzazione a forzare l’assemblaggio. L’opzione --force di mdadm, se utilizzata senza conoscere lo stato delle singole unità, può peggiorare seriamente la situazione.
Per le procedure specifiche di recupero rimandiamo al nostro articolo su come recuperare i dati da un array RAID.
Windows: come riconoscere un RAID in difficoltà
Un controller RAID hardware può presentare al sistema operativo un singolo disco logico. In quel caso Windows non conosce necessariamente lo stato dei singoli membri e servono gli strumenti diagnostici del produttore del controller.
Con Storage Spaces, disponibile anche su Windows 11, la situazione è diversa: Windows gestisce pool di dischi fisici e unità virtuali con configurazioni di resilienza differenti. Windows Server aggiunge inoltre Storage Spaces Direct (S2D), che permette di distribuire la resilienza tra più server.
Una verifica iniziale, da PowerShell con privilegi amministrativi, è la seguente:
Get-PhysicalDisk | Select FriendlyName, SerialNumber, HealthStatus, OperationalStatus
Per esaminare le unità virtuali:
Get-VirtualDisk | Select FriendlyName, ResiliencySettingName, HealthStatus, OperationalStatus
È importante distinguere lo stato dei singoli dischi fisici da quello del volume virtuale, ossia l’unità di archiviazione che Windows crea combinando più dischi. Se un hard disk si guasta, il volume può continuare a funzionare grazie alle copie dei dati o alle informazioni di parità conservate sugli altri dischi. Tuttavia, il volume non dispone più della protezione originaria: un ulteriore guasto potrebbe provocare la perdita dei dati. Per questo, anche quando Windows permette ancora di aprire e modificare normalmente i file, è fondamentale controllare se il sistema abbia perso parte della propria capacità di tollerare altri guasti.
La documentazione Microsoft sugli stati di Storage Spaces distingue condizioni particolarmente significative: lo stato Incomplete può indicare che mancano unità contenenti copie ancora aggiornate dei dati. Lo stato Degraded segnala invece una resilienza ridotta con copie obsolete su una o più unità mancanti o guaste. No Redundancy rappresenta una condizione più grave: il disco virtuale ha perso dati a causa del superamento della propria tolleranza ai guasti.
Gli errori che Windows può mostrare prima del guasto
È possibile svolgere un controllo più approfondito ricorrendo alla seguente cmdlet:
Get-PhysicalDisk |
  Get-StorageReliabilityCounter |
  Select DeviceId, Temperature, PowerOnHours,
         ReadErrorsUncorrected,
         WriteErrorsUncorrected
L’istruzione che vi presentiamo consulta i contatori di affidabilità esposti dal sottosistema di archiviazione. La disponibilità e l’attendibilità dei singoli valori dipendono dai dispositivi e dai driver; alcuni controller RAID non espongono direttamente questi dati.
Non basta quindi cercare uno stato Healthy: un aumento degli errori non corretti oppure la comparsa ripetuta di timeout può essere più significativo dell’indicatore generale di salute. Su Windows Server conviene inoltre controllare i registri System e quelli specifici del sottosistema di storage nel Visualizzatore eventi (Windows+R, eventvwr.msc).
Tra gli eventi da esaminare figurano gli errori di I/O, i reset delle connessioni verso i dispositivi e i problemi segnalati dai driver di archiviazione. Per esempio, gli eventi con ID 129, 153 e 157 possono fornire indizi utili, ma vanno interpretati insieme alla relativa origine e agli altri eventi registrati.
Windows Server: il rebuild può non partire anche dopo aver sostituito il disco
Con Storage Spaces non è sempre sufficiente aggiungere una nuova unità fisica per ottenere immediatamente il ripristino della resilienza. Il sistema deve poter collocare nuovamente le copie o i blocchi di parità rispettando i vincoli della configurazione, compresi numero di colonne, disposizione dei dati e domini di errore.
Per controllare le attività in corso, si può impartire il comando che segue: mostra eventuali operazioni prolungate, compresa la riparazione dei dischi virtuali.
Get-StorageJob
Nelle configurazioni Storage Spaces autonome, quando la diagnosi ha confermato che esistono le condizioni per procedere, l’amministratore può utilizzare Repair-VirtualDisk sull’unità virtuale corretta.
Non bisogna però eseguire il comando su un pool che mostra ulteriori errori, né dichiarare manualmente guasto un disco ancora accessibile senza averne verificato l’identità.
Microsoft descrive le procedure nella guida Manage Disks in Standalone Storage Spaces.
Quando il rebuild RAID non è la prima operazione da eseguire
Supponiamo che una configurazione RAID 5 abbia perso un disco, mentre uno dei tre superstiti comincia a segnalare errori di lettura. La ricostruzione completa potrebbe richiedere una lettura estesa di tutte le unità rimaste. Una copia selettiva dei file più importanti, invece, potrebbe accedere soltanto a una parte dei dati.
La seconda operazione può essere preferibile quando non esiste un backup aggiornato e il volume è ancora leggibile, purché le condizioni dei dischi permettano di procedere senza aumentare inutilmente il rischio.
Non è una regola assoluta: su array molto instabili, anche il semplice tentativo di copiare file può aggravare un guasto. In questi casi può risultare più prudente acquisire immagini conservative delle unità e lavorare successivamente sulle copie.
Prima di scegliere come muoversi, bisogna quindi stabilire se il problema riguardi soltanto un componente sostituibile oppure se la situazione sia già diventata un’emergenza di recupero dati. Sostituire in sequenza le unità senza identificare la causa potrebbe non risolvere nulla.
È inoltre opportuno osservare che se i blocchi di dati e quelli di parità non coincidono, il RAID può rilevare una discrepanza, ma non necessariamente capire quale blocco contenga l’informazione corretta.
Tecnologie come quelle alla base del file system ZFS associano checksum ai blocchi e possono utilizzarli, insieme alla ridondanza disponibile, per individuare e correggere alcune forme di corruzione silenziosa. Abbiamo approfondito il funzionamento nella nostra guida a ZFS e alla protezione dell’integrità dei dati.
Anche questi meccanismi, tuttavia, non sostituiscono una copia di sicurezza indipendente.
RAID non è un backup: la regola da tenere a mente
La funzione principale della ridondanza è mantenere accessibili i dati quando si verifica uno dei guasti previsti dalla configurazione.
Il backup risponde a un’altra esigenza: recuperare una copia utilizzabile quando i dati originali non sono più disponibili, sono stati modificati accidentalmente oppure risultano compromessi.
Una configurazione RAID 1 può replicare anche la cancellazione di un file; un RAID 5 può continuare a funzionare mentre un ransomware cifra le cartelle condivise. RAID 6 può tollerare due guasti completi, ma non garantisce la sopravvivenza dei dati se un evento distrugge l’intero NAS.
La strategia di backup 3-2-1 affronta proprio la necessità di conservare copie indipendenti.
Quando un disco RAID si guasta, bisogna quindi subito chiedersi quanto sono affidabili le informazioni che il sistema dovrà utilizzare per ricostruire l’unità da sostituire. Un array degradato può continuare a funzionare per giorni ma finché la ridondanza non torna integra, ogni errore aggiuntivo può avere conseguenze molto più gravi del guasto in sé.


