

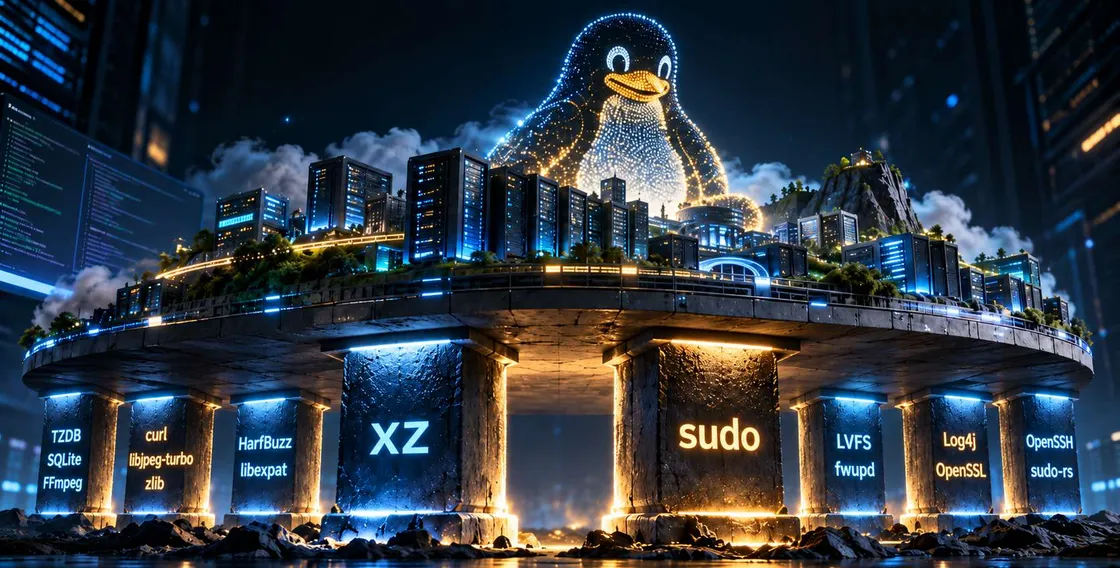
Internet sembra poggiare su datacenter giganteschi, reti globali, cloud distribuiti e società con bilanci miliardari. Scendendo un po’ più in profondità nello stack software, però, emerge una realtà molto diversa: alcune funzioni utilizzate ogni giorno da miliardi di dispositivi dipendono ancora dal lavoro continuativo di pochissime persone.
Una recente analisi pubblicata da Data Drop permette di quantificare il fenomeno osservando 23 progetti open source fondamentali e la loro cronologia di sviluppo tra ottobre 2025 e ottobre 2026. Il risultato più immediato è notevole: 11 progetti su 23 mostrano soltanto una o due persone con almeno dieci modifiche nel periodo considerato.
Non significa che ciascun progetto abbia uno o due maintainer: la misura, tuttavia, fotografa quanto possa restringersi il gruppo che lavora con continuità sul codice.
Heartbleed nel 2014, Shellshock nello stesso anno, Log4Shell nel 2021 e la backdoor XZ scoperta nel 2024 hanno mostrato che il valore economico e operativo di una libreria aperta può aumentare enormemente senza che crescano in proporzione le risorse destinate alla sua manutenzione. A distanza di oltre 10 anni dal caso Heartbleed, la questione resta aperta.
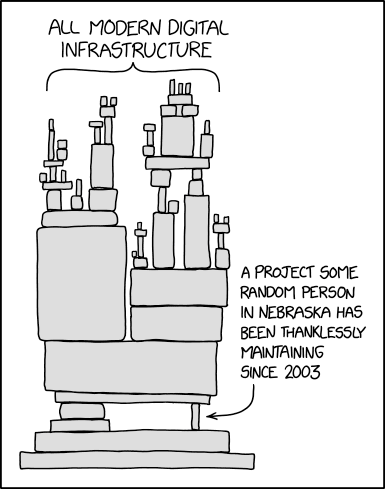
L’iconica vignetta di Randall Munroe, xkcd 2347. CC BY-NC 2.5.
Usare gratuitamente il codice non significa abusare dell’open source
Il fatto che un’azienda utilizzi gratuitamente software open source per costruire un prodotto commerciale non rappresenta di per sé un comportamento scorretto. Al contrario, molte licenze libere nascono proprio per garantire la possibilità di utilizzare, studiare, modificare e ridistribuire il codice anche in attività economiche.
Abbiamo richiamato lo stesso principio parlando dei 43 anni del progetto GNU e del rapporto tra software libero e Linux: la libertà del codice, però, non rende gratuito il lavoro necessario per mantenerlo. Analizzare bug, verificare vulnerabilità, gestire bug, preservare la compatibilità, mantenere l’infrastruttura di test e preparare nuove release richiede tempo e competenze molto specialistiche.
Le licenze possono concedere legittimamente l’uso commerciale senza imporre un contributo economico; allo stesso tempo, un’impresa che basa parti rilevanti dei propri prodotti su determinati componenti dovrebbe chiedersi quale rischio comporti lasciare la manutenzione quasi interamente sulle spalle di poche persone. È una questione di sostenibilità del software libero, certo, ma anche di gestione del rischio aziendale.
Un’impresa può spendere milioni per progettare hardware, servizi cloud o applicazioni e dipendere contemporaneamente da una libreria mantenuta nel tempo libero da uno sviluppatore. Finché tutto funziona, la sproporzione rimane invisibile; quando compare una vulnerabilità critica o il maintainer decide di ridurre l’impegno, la dipendenza emerge all’improvviso.
Su IlSoftware.it ne abbiamo parlato più volte osservando il problema da angolazioni diverse. I casi di FFmpeg e delle Big Tech che utilizzano il suo codice, di curl, presente secondo le stime su oltre 30 miliardi di installazioni e di sudo, mantenuto per decenni principalmente da Todd C. Miller mostrano la stessa asimmetria: aziende e infrastrutture con risorse enormi possono dipendere da codice il cui mantenimento fa affidamento “a poche teste”.
Un database dei fusi orari da cui dipendono miliardi di dispositivi
Uno degli esempi più efficaci individuati da Data Drop riguarda il Time Zone Database, spesso chiamato tzdb o Olson Database. È la raccolta che descrive offset UTC, passaggi tra ora solare e ora legale, modifiche decise dai governi e numerose informazioni storiche necessarie per trasformare un istante universale nell’ora locale corretta.
Calendari, sistemi di prenotazione, applicazioni finanziarie, timestamp, servizi distribuiti e smartphone devono sapere se una regione cambierà ora in una certa data oppure manterrà permanentemente lo stesso schema.
La versione tzdb 2026e, pubblicata il 29 settembre 2026, contiene per esempio l’aggiornamento relativo a una provincia canadese che passa permanentemente a UTC-05 dal 31 ottobre 2026. Decisioni politiche di questo tipo devono trasformarsi rapidamente in dati tecnici utilizzabili da sistemi operativi, runtime e applicazioni.
Secondo l’analisi della cronologia del progetto, tra ottobre 2025 e ottobre 2026 risultano 251 modifiche: 218 attribuite a Paul Eggert e 28 a Tim Parenti. Eggert coordina ufficialmente tzdb dal 2012.
Data Drop considera una base minima superiore a 4 miliardi di dispositivi che poggiano sul lavoro di Eggert, soltanto sommando Android e iPhone, senza includere server, PC, Mac e una lunga serie di apparati embedded.
tzdb non è comunque un file amministrato informalmente da una persona. Dal 2012 esiste una struttura regolata dalla RFC 6557: IETF e IANA hanno definito il ruolo del TZ Coordinator, la mailing list pubblica e procedure precise per gli aggiornamenti.
XZ ha dimostrato quanto può diventare pericolosa la pressione sui maintainer
Il caso più delicato resta XZ Utils. Lasse Collin ha seguito per anni il progetto, che comprende liblzma, libreria ampiamente utilizzata nell’ambiente Unix e Linux. A giugno 2022 Collin spiegò pubblicamente le difficoltà nel sostenere il lavoro sul progetto mentre attraversava anche problemi personali.
Durante quella fase iniziò a crescere l’attività del contributor conosciuto come Jia Tan. Nel 2023, secondo la ricostruzione basata sulla cronologia Git, Jia Tan effettuò 304 modifiche contro le 172 di Collin. Gradualmente acquisì fiducia e maggiori possibilità di intervenire sul progetto.
Le release XZ 5.6.0 e 5.6.1 pubblicate nel 2024 contenevano una backdoor estremamente sofisticata. L’attacco fallì quasi per caso: Andres Freund, ingegnere Microsoft e sviluppatore PostgreSQL, notò consumo anomalo di CPU, una serie di errori e circa mezzo secondo di ritardo durante alcune connessioni SSH su Debian unstable. Continuò a investigare fino a individuare la manipolazione e il 29 marzo 2024 pubblicò i risultati delle sue verifiche.
Quando avvenuto nel caso di XZ non dimostra che un progetto mantenuto da poche persone sia automaticamente insicuro. Rende però evidente quanto la combinazione tra pressione sul maintainer, necessità di delegare e insufficiente capacità di revisione possa aprire spazi alle ingerenze di malintenzionati e criminali informatici.
È esattamente il timore richiamato anche da Todd C. Miller nel caso di sudo. Come abbiamo spiegato nell’approfondimento dedicato alla sostenibilità di sudo, passare il controllo di un progetto così sensibile a nuovi responsabili non equivale semplicemente a consegnare le credenziali del repository.
sudo: quando un componente di sicurezza dipende da un maintainer storico
sudo è proprio uno dei progetti esaminati da Data Drop. Miller ne segue lo sviluppo dal 1993 e nel 2026 ha spiegato pubblicamente di aver bisogno di sostegno per proseguire il lavoro dopo la conclusione del supporto economico fornito per anni dalla sua precedente azienda.
sudo governa l’esecuzione di comandi con privilegi elevati su moltissimi sistemi Unix e Linux: nel 2025, per esempio, le vulnerabilità CVE-2025-32462 e CVE-2025-32463 hanno richiesto correzioni per problemi che potevano portare all’escalation locale dei privilegi.
L’esistenza di sudo-rs, reimplementazione in Rust adottata anche da Ubuntu 25.10, non rende irrilevante il problema. Una riscrittura memory-safe può eliminare intere categorie di errori legati alla gestione della memoria, ma non sostituisce automaticamente decenni di conoscenza operativa, compatibilità, casi limite e procedure di manutenzione. E soprattutto non crea per magia un modello economico sostenibile.
SQLite: un numero enorme di installazioni, un gruppo minuscolo
Un altro esempio particolarmente significativo è SQLite. Il database embedded creato da D. Richard Hipp nel 2000 non richiede un server separato: applicazione e database lavorano direttamente su file locali: la semplicità dell’architettura ne ha favorito una diffusione eccezionale.
SQLite compare su Android, iPhone, macOS, Windows e nei principali browser. Il progetto stesso ritiene plausibile l’esistenza di oltre 1.000 miliardi di database SQLite attivi, perché un singolo dispositivo può ospitarne decine o centinaia creati indipendentemente da applicazioni e servizi.
Nell’ultimo anno analizzato da Data Drop soltanto 4 persone hanno effettuato modifiche al progetto e 3 hanno superato la soglia dei dieci commit: Hipp da solo rappresenta circa il 63% delle modifiche considerate.
SQLite aiuta però anche a evitare un’equazione troppo semplicistica tra open source e lavoro gratuito: Hwaci, la società fondata da Hipp, vende supporto, servizi professionali e prodotti collegati al progetto. La base degli sviluppatori resta molto piccola, ma esiste una struttura economica costruita intorno al codice.
FFmpeg e l’effetto collaterale delle vulnerabilità trovate dall’AI
Il carico sui maintainer non dipende soltanto dal numero di righe da scrivere. Sempre più spesso deriva dal numero di segnalazioni che qualcuno deve verificare: l’uso dell’AI sta rendendo particolarmente evidente il problema.
A novembre 2025 abbiamo raccontato la polemica tra FFmpeg e Google innescata dalla segnalazione di una vulnerabilità individuata con sistemi AI. FFmpeg fornisce librerie e strumenti utilizzati per codifica, decodifica, conversione e streaming audio-video; il suo codice entra direttamente o indirettamente in moltissime applicazioni professionali.
Dal punto di vista di chi mantiene un progetto, anche una segnalazione tecnicamente valida ma di impatto limitato richiede tempo: qualcuno deve riprodurre il problema, leggere il codice, stabilire se esista davvero una vulnerabilità, valutarne la gravità, sviluppare eventualmente una correzione, eseguire test e gestire la comunicazione.
L’AI applicata alla ricerca di vulnerabilità riduce drasticamente il costo necessario per produrre report, ma non riduce allo stesso modo il costo umano della loro validazione. Anzi, può scatenare un effetto opposto.
curl: quando il successo stesso genera un carico difficile da sostenere
Daniel Stenberg ha espresso un problema molto simile parlando di curl. Nel nostro approfondimento sulla pressione esercitata sui maintainer di curl abbiamo ricordato una stima superiore a 30 miliardi di installazioni, comprendendo smartphone, televisori, automobili, router, dispositivi embedded, servizi cloud e applicazioni enterprise.
curl e libcurl supportano HTTP, HTTPS e numerosi altri protocolli; l’utility è anche inclusa in Windows. Il fatto che il software sia diffusissimo, però, non implica che il progetto disponga di risorse economiche proporzionate.
Stenberg ha descritto l’aumento delle segnalazioni di sicurezza, comprese quelle prodotte con strumenti AI, come un carico sempre più impegnativo. Più un progetto diventa importante, più persone e aziende lo analizzano; cresce quindi la quantità di report da valutare, anche quando la maggior parte non porta alla scoperta di una vulnerabilità significativa.
curl rappresenta comunque un caso relativamente positivo rispetto ad altri progetti. Nell’anno esaminato da Data Drop 11 persone superano la soglia delle 10 modifiche applicate al codice del progetto; Stenberg lavora sul progetto a tempo pieno grazie anche a contratti di supporto; curl riceve inoltre contributi attraverso Open Collective e ha ottenuto 195.000 euro dalla tedesca Sovereign Tech Agency.
libjpeg-turbo, zlib e HarfBuzz: componenti quasi invisibili ma ovunque
Scendendo ancora di livello si incontrano librerie che milioni di utenti impiegano senza conoscerne neppure il nome.
libjpeg-turbo, per esempio, accelera codifica e decodifica JPEG attraverso implementazioni SIMD (codice ottimizzato che esegue la stessa operazione su più dati contemporaneamente usando istruzioni specifiche della CPU) e compare in Android e Chromium. Nel periodo studiato da Data Drop, DRC (abbreviazione usata da D. R. Commander, sviluppatore e maintainer storico del progetto) firma quasi il 98% delle modifiche.
Il progetto non vive esclusivamente di volontariato: finanzia parte delle attività attraverso sponsorizzazioni e lavori commissionati. Rimane tuttavia evidente la sproporzione tra l’enorme superficie di utilizzo e il numero di persone che conoscono abbastanza profondamente il codice da modificarlo con continuità.
zlib costituisce un esempio emblematico. Creata nel 1995 da Jean-loup Gailly e Mark Adler, la libreria di compressione compare in una quantità enorme di programmi e formati. Esaminando il resoconto prodotto da Data Drop, soltanto 2 persone raggiungono la soglia dei 10 interventi annuali sul codice.
HarfBuzz svolge invece il text shaping: trasforma sequenze Unicode nei glifi corretti, calcolando forme, legature, posizioni e combinazioni dei caratteri. La libreria opera dietro le quinte in Android, Chrome, Firefox, Edge, Kindle e molti altri prodotti. Behdad Esfahbod firma circa l’85% delle modifiche considerate, anche se altri sviluppatori partecipano regolarmente.
Monaco prova a invertire il modello: pagare prima che qualcosa si rompa
Esistono però esempi che vanno nella direzione opposta. Ad agosto 2026 abbiamo raccontato perché Monaco di Baviera ha deciso di finanziare direttamente libexpat, una libreria C per l’analisi di documenti XML presente su almeno 2.700 server Linux della municipalità.
libexpat compare nella catena software di Python, Firefox, QGIS, Audacity, WinSCP e numerosi altri prodotti. E così, la città tedesca ha scelto di utilizzare il programma Open Source Sabbatical per sostenere attività di sviluppo, sicurezza e manutenzione.
Monaco ha dapprima osservato le proprie dipendenze e poi ha deciso di investire su una libreria realmente presente nella propria infrastruttura. È una forma di manutenzione preventiva delle dipendenze: finanziare il componente prima che una vulnerabilità o l’assenza di un maintainer producano un costo molto più elevato.
Si tratta di un modello che anche le imprese potrebbero replicare: un inventario dei componenti software inclusi in un’applicazione o in un sistema, con librerie, versioni e dipendenze utilizzate (SBOM) permette di sapere quali componenti open source fanno parte di un prodotto o di un’infrastruttura; gli strumenti di Software Composition Analysis aiutano invece a confrontare quelle dipendenze con database di vulnerabilità note e versioni obsolete.
Un’organizzazione dovrebbe anche capire da quali progetti dipendono il funzionamento e la sicurezza dei propri sistemi, chi li mantiene e con quali risorse. Una libreria può infatti risultare perfettamente aggiornata oggi, ma diventare un punto debole domani se il progetto dipende da pochi soggetti, non dispone di fondi sufficienti o fatica a gestire segnalazioni e correzioni.
LVFS: Dell e Lenovo iniziano a pagare un’infrastruttura che usano
Un altro caso concreto arriva dal mondo hardware. Il finanziamento di LVFS da parte di Dell e Lenovo offre un esempio interessante di responsabilizzazione dei produttori.
Linux Vendor Firmware Service (LVFS) distribuisce aggiornamenti firmware ai sistemi Linux attraverso fwupd: per un produttore di PC, poter recapitare firmware aggiornati agli utenti Linux riduce problemi di supporto, semplifica la gestione delle vulnerabilità e migliora l’esperienza dei clienti.
Dopo le richieste pubbliche del maintainer Richard Hughes, Dell e Lenovo sono diventate sponsor di livello premier, con una quota annuale indicata in 100.000 dollari. LVFS ha inoltre introdotto un modello di fair use che chiede ai produttori con un utilizzo significativo della piattaforma di contribuire economicamente oppure attraverso sviluppatori dedicati.
Se un’infrastruttura open source consente a un produttore di risparmiare denaro e offrire un servizio migliore, finanziarne il funzionamento non è beneficenza; diventa una parte del costo necessario per mantenere quel servizio.
La Germania sta finanziando componenti che il mercato tende a ignorare
Un ruolo crescente appartiene anche alla già citata Sovereign Tech Agency tedesca, che finanzia progetti open source considerati essenziali per l’infrastruttura digitale.
Tra gli interventi richiamati da Data Drop figurano 596.160 euro destinati a Log4j, 405.888 euro a OpenSSL, 200.000 euro a OpenSSH e 195.000 euro a curl. Anche FFmpeg ha ricevuto sostegno attraverso iniziative della stessa organizzazione.
Non si tratta di introdurre nuove funzioni capaci di attirare utenti o generare ricavi immediati: i fondi possono coprire test, sicurezza, documentazione, manutenzione, build, miglioramento delle procedure e riduzione del debito tecnico.
La stessa riflessione è alla base della proposta che abbiamo analizzato nell’articolo GitHub: l’Europa crei un fondo per investire sull’open source. L’idea è creare un Fondo Tecnologico Sovrano Europeo capace di sostenere tecnologie open source dalle quali dipendono imprese e Pubblica Amministrazione.
Il concetto di sovranità tecnologica acquista così un significato pratico: non basta possedere server o sviluppare piattaforme europee se una parte critica dello stack dipende da componenti che rischiano di perdere i propri maintainer.
Il problema economico dell’open source non si risolve con una regola unica
Non esiste un modello di finanziamento che funzioni allo stesso modo per tutti. SQLite vende supporto e servizi; curl combina contratti, sponsor e finanziamenti pubblici; LVFS chiede un contributo ai vendor che utilizzano intensamente la piattaforma. Monaco remunera direttamente il lavoro su una dipendenza individuata nei propri server. Sovereign Tech Agency utilizza denaro pubblico per progetti considerati infrastrutturali.
Altri progetti possono preferire fondazioni, donazioni, GitHub Sponsors, Open Collective o contratti commerciali e alcuni maintainer possono legittimamente non voler trasformare un progetto personale in un’attività a tempo pieno.
Il principio comune dovrebbe differente: chi dipende professionalmente da una tecnologia deve almeno conoscere le condizioni in cui quella tecnologia viene mantenuta. Serve sapere chi può intervenire su di esse, quante persone possiedono privilegi di release, quale capacità di risposta esiste e cosa accadrebbe se uno dei responsabili smettesse di lavorare al progetto. E chiedersi cosa si può fare, concretamente, per sostenere il lavoro altrui ed evitare di correre rischi.


